Speech-to-Text di Perangkat Makin Umum: Arti Rilis Minggu Ini
Ubuntu Myna, model Tether, dan dua rilis lain membuat speech-to-text di perangkat ramai. Ini yang berubah, kenapa penting, dan cara Snipset menjalankannya.
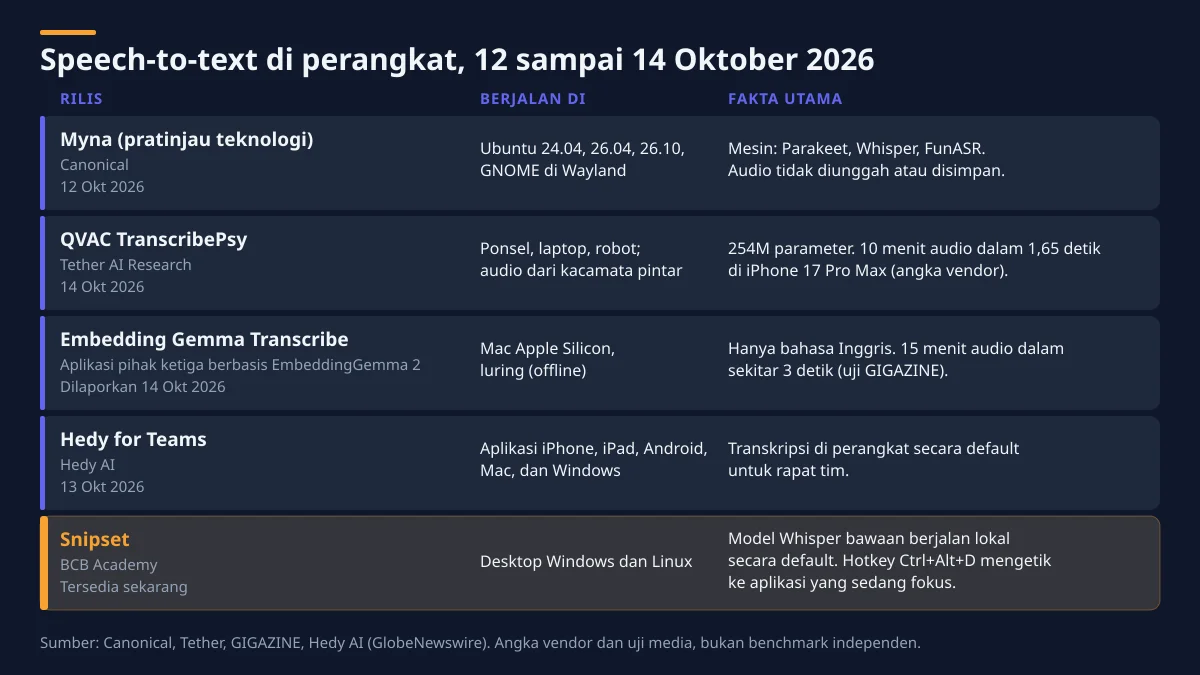
Antara 12 dan 14 Oktober, empat peluncuran dan ulasan membuat speech-to-text di perangkat ramai diberitakan: Canonical membuka technology preview Myna untuk Ubuntu, Tether merilis model suara ringkas untuk ponsel dan kacamata pintar, GIGAZINE menguji aplikasi dikte offline untuk Mac yang dibangun di atas model embedding Google, dan Hedy membawa transkripsi di perangkatnya ke paket tim baru. Speech-to-text yang berjalan di perangkatmu sendiri bukan lagi pengaturan khusus untuk penggemar privasi. Ia sedang menjadi cara standar membangun fitur mengetik dengan suara.
Kami sudah menghadirkan dikte lokal di Snipset sejak sebelum minggu ini, jadi kami membaca peluncuran-peluncuran ini dengan saksama. Berikut apa yang dilakukan masing-masing, kesamaan di antara mereka, dan artinya bagi cara kamu menulis.
Ubuntu Myna: Dikte Lokal yang Menyatu dengan Desktop
Pada 12 Oktober, Canonical merilis Myna sebagai technology preview. Idenya sederhana: taruh kursor di kolom teks mana pun, tekan pintasan, bicara, lalu Myna mengetikkan ucapanmu ke aplikasi yang sedang kamu pakai. Menurut Canonical, pengenalan suara berjalan sepenuhnya di komputermu. Setelah model diunduh, kamu tidak butuh koneksi internet, dan audiomu tidak diunggah maupun disimpan.
Myna hadir dengan beberapa pilihan mesin open-weight (Parakeet, Whisper, dan FunASR), masing-masing dengan kompromi sendiri antara dukungan bahasa, akurasi, dan kebutuhan perangkat keras. Preview ini berjalan di Ubuntu 24.04 LTS, 26.04 LTS, dan 26.10 dengan GNOME di Wayland, dan pemilik GPU NVIDIA yang didukung bisa memilih mesin dengan akselerasi GPU.
Ada dua pilihan desain yang menarik. Canonical menjaga Myna tetap fokus pada dikte: ia bukan asisten suara dan tidak mengendalikan desktopmu. Lalu menurut OMG! Ubuntu, kalau kolom teks kehilangan fokus saat kamu bicara, teksnya dibuang, bukan ditempel ke jendela yang tidak kamu maksud.
Tether QVAC TranscribePsy: Model Suara untuk Ponsel dan Kacamata Pintar
Pada 14 Oktober, Tether AI Research merilis QVAC TranscribePsy, model pengenalan suara open-source dan multibahasa dengan 254 juta parameter. Model ini dirancang untuk berjalan di ponsel, laptop, dan robot, serta mentranskripsi audio dari kacamata pintar yang terhubung hampir secara real time, tanpa mengirim audio ke server.
Angka dari Tether sendiri cukup ambisius. Perusahaan itu melaporkan bahwa build Core ML-nya mentranskripsikan 10 menit audio dalam 1,65 detik di iPhone 17 Pro Max, dan modelnya mencapai word error rate 8,02% di Open ASR Leaderboard. Model ini mencakup 25 bahasa Eropa di laptop dan 8 bahasa di ponsel. Ini angka dari vendor, bukan benchmark independen, tetapi arahnya jelas: model suara makin kecil sampai bisa tinggal di perangkat yang mendengarmu.
Embedding Gemma Transcribe: Dikte Offline di Mac
GIGAZINE menguji Embedding Gemma Transcribe pada 14 Oktober. Ini aplikasi macOS gratis untuk Apple Silicon yang dibangun di atas EmbeddingGemma 2 milik Google, model embedding multimodal yang sebenarnya tidak pernah dirancang untuk transkripsi. Aplikasi ini memasangkan model tersebut dengan model yang lebih kecil, yang memilih kata yang cocok dari kamus berisi sekitar 229.000 kata bahasa Inggris.
Kamu cukup menahan tombol Option kanan, bicara, lalu melepasnya, dan teksnya muncul di aplikasi yang sedang kamu pakai. Audio diproses di Mac dan tidak dikirim ke server. Dalam uji GIGAZINE, pidato berdurasi 15 menit 4 detik ditranskripsikan dalam sekitar 3 detik. Kekurangannya ada di bahasa: aplikasi ini hanya memahami bahasa Inggris, dan developernya melaporkan word error rate sekitar 5%.
Hedy for Teams: Di Perangkat secara Bawaan, Bahkan untuk Kantor
Pada 13 Oktober, Hedy AI meluncurkan Hedy for Teams, paket untuk asisten rapat AI mereka. Pengenalan suara berjalan di perangkat tiap anggota secara bawaan, dan perusahaan itu menyebut audio percakapan tidak pernah sampai ke server mereka. Admin mengelola kursi dan tagihan, tetapi tidak bisa membuka sesi rapat pribadi anggota. Paket ini dihargai US$99,99 per kursi per tahun untuk tim berisi 2 sampai 200 orang.
Yang satu ini penting karena ia produk bisnis. Audio rapat termasuk data paling sensitif yang dihasilkan sebuah perusahaan, dan Hedy bertaruh bahwa menyimpannya di perangkat adalah nilai jual, bukan keterbatasan.
Kesamaan Keempat Peluncuran Speech-to-Text Ini
Kalau dibaca berdampingan, keempat rilis ini punya tiga pola yang sama:
- Modelnya yang mendatangi audio. Semuanya memindahkan pengenalan suara ke laptop atau ponsel yang berada di dekat mikrofon. Kata-katamu diubah menjadi teks sebelum hal lain terjadi.
- Privasi dinyatakan dengan bahasa yang lugas. Tidak diunggah, tidak disimpan, tidak pernah sampai ke server kami. Setiap vendor menyebutkan ke mana audiomu pergi, dan jawabannya: tetap di perangkat.
- Dikte adalah fitur keyboard. Myna dan Embedding Gemma Transcribe sama-sama bekerja lewat hotkey dan mengetik ke aplikasi apa pun yang sedang fokus. Suara diperlakukan sebagai cara lain untuk mengetik, bukan aplikasi terpisah yang harus kamu buka.
Tentu ada kompromi. Model lokal lebih kecil daripada model cloud terbesar, jadi akurasinya bergantung pada model, mikrofon, dan aksenmu. Cakupan bahasanya juga sangat beragam: salah satu aplikasi ini hanya mendukung bahasa Inggris. Pemrosesan di perangkat juga memakai CPU atau GPU milikmu sendiri. Itulah sebabnya alat lokal yang paling berguna membiarkanmu memilih mesinnya, dan tetap menyediakan opsi cloud untuk saat kamu membutuhkannya.
Cara Snipset Menangani Dikte Lokal Saat Ini
Fitur dikte Snipset mengikuti pola yang sama, di Windows dan Linux. Tekan Ctrl+Alt+D di aplikasi apa pun, bicara, dan teksnya langsung diketik ke kolom yang sedang kamu kerjakan. Ketuk sekali untuk mulai dan sekali lagi untuk berhenti. Di Windows, kamu juga bisa menahannya untuk push-to-talk; di Linux dengan Wayland pintasannya selalu toggle, karena portal desktop tidak melaporkan saat tombol dilepas.
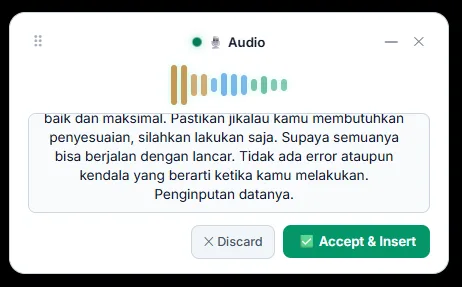
Begini yang terjadi di balik layar:
| Pertanyaan | Yang dilakukan Snipset |
|---|---|
| Di mana pengenalan suara berjalan? | Di komputermu secara bawaan, dengan model Whisper base yang sudah di-fine-tune untuk bahasa Indonesia dan ikut terpasang (sekitar 82 MB) |
| Ada opsi cloud? | Ada, kalau kamu aktifkan sendiri: Gemini Cloud dengan Google API key milikmu |
| Bahasa apa saja? | Deteksi otomatis, bahasa Indonesia, atau bahasa Inggris |
| Bagaimana dengan perapian teks? | Mode "Smart" merapikan transkrip dengan model Ollama lokal kalau kamu punya. Mode "Verbatim" mempertahankan teks mentahnya |
| Di mana audio disimpan? | Di data aplikasi lokal, dan dihapus setelah 24 jam secara bawaan. Kamu bisa mengubah lama penyimpanannya atau menghapusnya kapan saja |
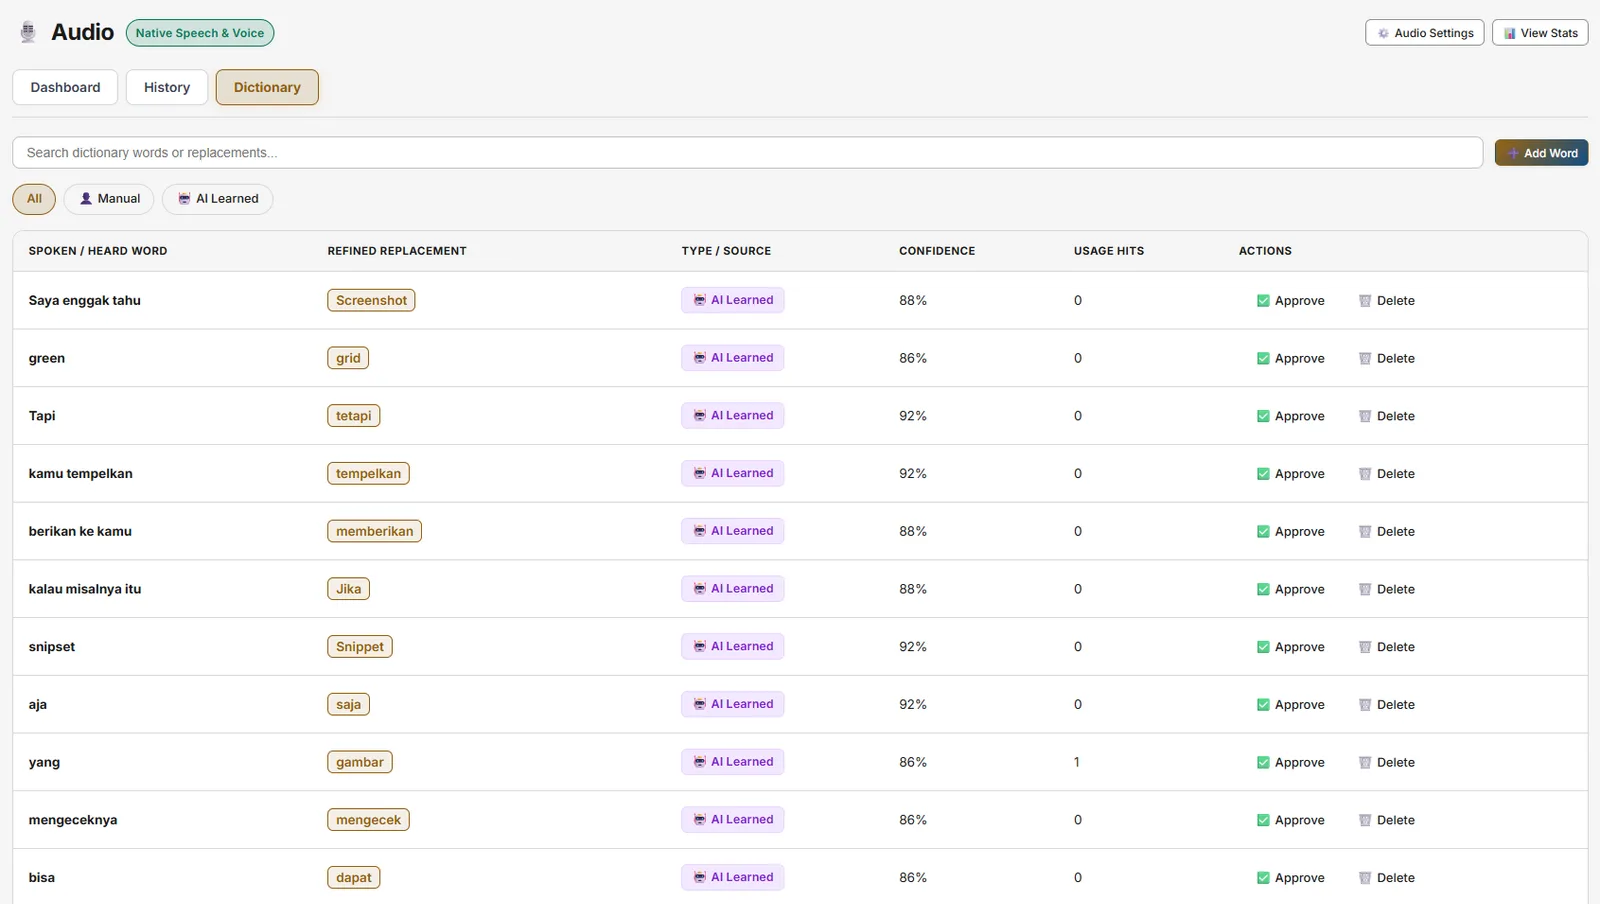
Snipset juga mempelajari kosakatamu tanpa menebak-nebak. Setelah kamu mendikte, Snipset memperhatikan koreksi yang kamu buat selama beberapa detik (12 detik secara bawaan). Setiap koreksi menjadi saran yang menunggu di Speech Dictionary milikmu, dan tidak ada yang berubah sampai kamu menyetujuinya.
Karena transkrip juga masuk ke riwayat clipboard, paragraf yang kamu diktekan berada di samping snippet, catatan, dan tugasmu. Kamu bisa mengembangkannya menjadi templat, menyimpannya sebagai catatan, atau menempelkannya lagi nanti. Panduan lengkapnya ada di dokumentasi audio, dan halaman privasi kami menjelaskan dengan tepat kapan audio meninggalkan perangkatmu (hanya kalau kamu memilih Gemini).
Kalau kamu ingin alasan yang lebih lengkap kenapa berbicara bisa lebih baik daripada mengetik, baca Berpikir Lebih Cepat dari Mengetik.
Coba Dikte Lokal di Snipset
Minggu ini menunjukkan bahwa speech-to-text di perangkat sudah bergeser dari sekadar janji menjadi standar. Kalau kamu ingin memakainya hari ini di desktop Windows atau Linux, bersama text expander, riwayat clipboard, dan catatan dalam satu aplikasi, cobalah Snipset. Setiap lisensi mencakup semua fitur, termasuk dikte.
Sumber
- Canonical, "Myna speech-to-text is now available as a technology preview", blog Ubuntu, 12 Oktober 2026: ubuntu.com/blog
- Joey Sneddon, "Ubuntu releases tech preview of Myna, its AI voice dictation tool", OMG! Ubuntu, 12 Oktober 2026: omgubuntu.co.uk
- Tether, "Tether Brings On-Device Speech Recognition to Smart Glasses and Humanoid Robots", 14 Oktober 2026: tether.io
- GIGAZINE, "Embedding Gemma Transcribe can transcribe 15 minutes of audio in about 3 seconds on a Mac", 14 Oktober 2026: gigazine.net
- Hedy AI, "Hedy AI Launches Hedy for Teams", GlobeNewswire melalui Business Insider, 13 Oktober 2026: markets.businessinsider.com