Productivity Tools
Audio & Speech (TTS / STT)
Tingkatkan produktivitas kerjamu dengan voice dictation (STT), continuous dictation, Read Aloud (TTS), post-hoc keystroke learning, dan kamus suara personal Snipset.
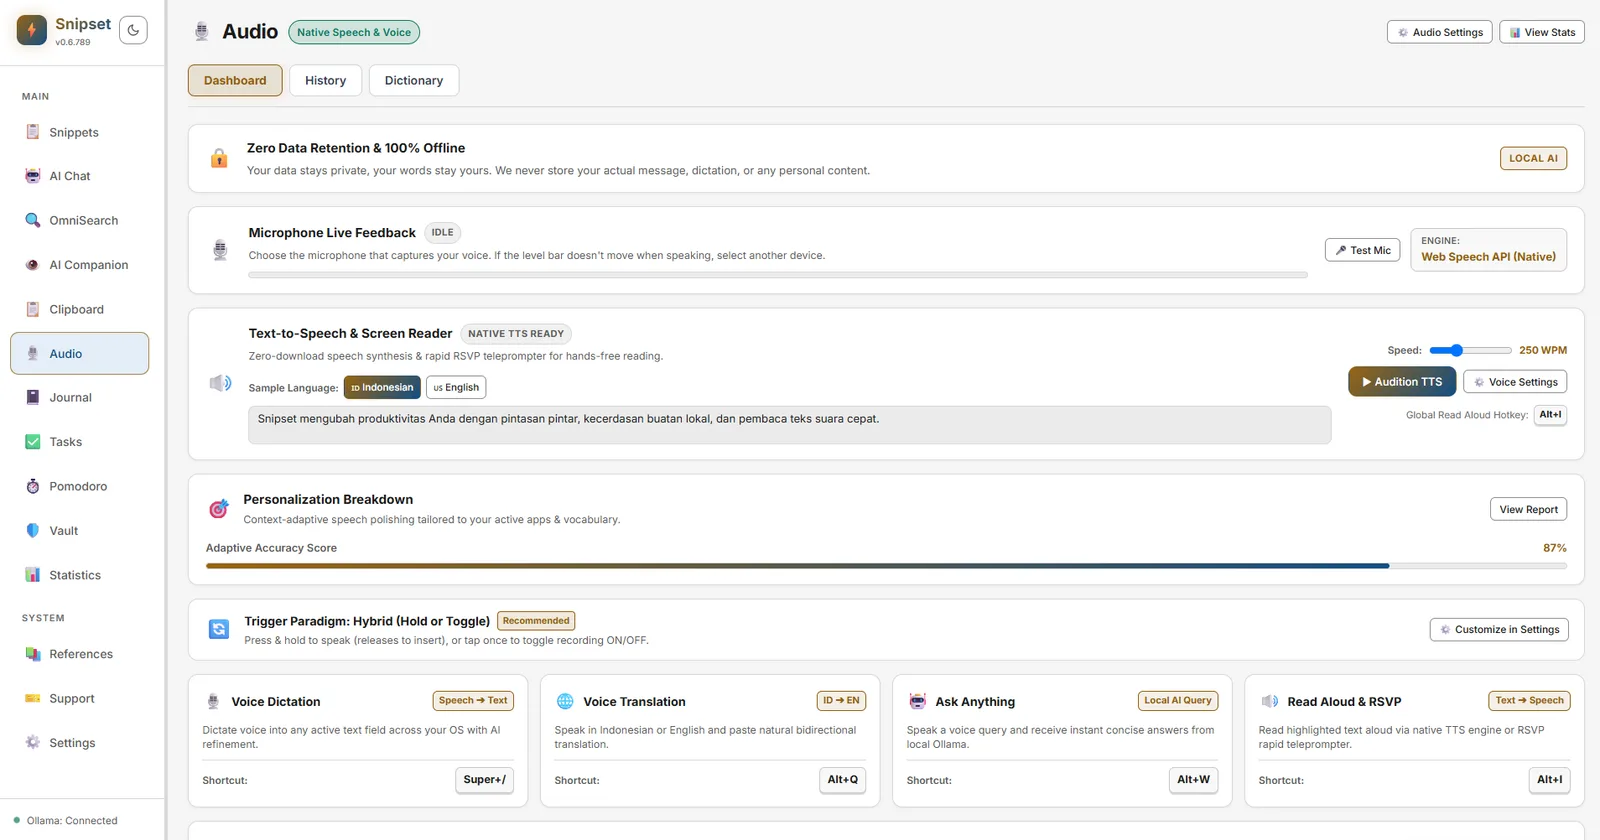
Rangkaian fitur Audio & Speech di Snipset mengintegrasikan Speech-to-Text (STT) lokal untuk voice dictation (ditenagai oleh whisper-rs dengan model ggml-base-id-q8_0.bin) dan Text-to-Speech (TTS) untuk Read Aloud (melalui Web Speech API WebView aktifmu) langsung ke dalam alur kerja desktopmu. STT berjalan sepenuhnya di perangkat tanpa telemetri, sementara TTS memakai suara sintesis yang terpasang di WebView (Edge, Chrome, atau WebView2). Fitur ini mendukung continuous dictation, batas keamanan rekaman 30 menit, dan fitur deteksi diam otomatis yang sengaja dinonaktifkan agar transkrip tidak terputus saat kamu berpikir.
Kemampuan Utama
- Multi-Mode Speech-to-Text (STT): Dikte teks langsung di posisi kursor aktif, terjemahkan antara Bahasa Inggris dan Bahasa Indonesia secara real-time, atau ajukan perintah suara langsung ke model AI (Ask Anything). Pintasan bawaan:
CommandOrControl+Alt+Duntuk dikte (antarmuka pengaturan menampilkanAlt+.sebagai placeholder),CommandOrControl+Alt+Tuntuk terjemahan, danCommandOrControl+Alt+Auntuk ask-anything. - Continuous Dictation & Ketahanan Jeda (Pause-Resilience): Bicara dengan tempo alami tanpa risiko kehilangan transkripsi saat berhenti sejenak untuk berpikir atau saat fokus jendela berpindah.
- Post-Hoc Keystroke Learning & Edit Rate: Melacak koreksi keyboard manual setelah sesi dikte untuk menghitung edit distance dan otomatis menyarankan kosakata baru ke kamus personal.
- Global Read Aloud (TTS): Salin teks apa pun di aplikasi mana saja dan tekan hotkey (
CommandOrControl+Alt+Rsecara bawaan; antarmuka pengaturan menampilkanAlt+Isebagai placeholder) untuk mendengarkan teks di papan klip dengan suara sistem atau ElevenLabs. - Umpan Balik TTS untuk Respons AI: Dengarkan jawaban AI secara langsung di dalam floating overlay card dengan kontrol pemutaran audio lengkap.
- Optimasi Audio Hardware: Automatic Gain Control (AGC), Noise Suppression, Acoustic Echo Cancellation (AEC), dan penyesuaian silence threshold.
- Local Whisper & Mode Offline: Transkripsikan audio secara lokal menggunakan mesin
whisper-rsdengan modelggml-base-id-q8_0.bin(sekitar 82 MB) tanpa pengiriman data ke server luar. Modelnya adalah Whisper base yang di-fine-tune untuk bahasa Indonesia oleh maleo-ai (Apache-2.0). Transkrip mentahnya berhuruf kecil tanpa tanda baca, kecuali kata tanda baca yang kamu ucapkan, yang diubah Snipset menjadi simbol; untuk tanda baca dan huruf kapital otomatis, pakai diktasi Smart (Layer 2) atau provider Gemini Cloud. Mesin ini ditampilkan sebagaiWhisper Base Indonesian (Offline)di dasbor speech. - Kamus Suara Personal (Custom Dictionary): Tambahkan akronim khusus, simbol kode, dan istilah teknis agar tidak salah ditranskripsi.
- Voice Profiles & Suara WebView: Pilih dari suara yang terpasang di WebView aktifmu (Edge, Chrome, atau WebView2). Kumpulan suara yang tersedia bergantung pada sistem operasi dan WebView; saat ini belum ada mesin SAPI5, Sherpa-ONNX, atau suara kloning khusus.
- Perlindungan Privasi & Kebijakan Retensi: Atur masa hapus otomatis untuk rekaman audio dan bersihkan seluruh riwayat audio dengan satu klik.
- Analitik Produktivitas & Ucapan: Pantau jumlah kata yang didiktekan, volume karakter yang dibacakan, metrik edit rate, dan waktu yang dihemat di dasbor Statistik.
Memulai
Akses pengaturan Audio & Speech melalui Sistem → Pengaturan → Audio & Dikte di bilah sisi (sidebar) Snipset:
+-------------------------------------------------------------+
| 🎙️ Mikrofon Aktif:   [ HyperX QuadCast S (Default)       ] |
| ⚡ Preset Audio:     [ ● USB / Headset  ○ Built-in / Far  ] |
| 🔊 Filter Hardware:  [✔] AGC   [✔] Noise Suppression [✔] AEC|
+-------------------------------------------------------------+
| 📝 Hotkey Dikte:       [ CommandOrControl+Alt+D    (UI: Alt+.) ] |
| 🌐 Hotkey Terjemahan:  [ CommandOrControl+Alt+T                ] |
| 🤖 Ask Anything:       [ CommandOrControl+Alt+A                ] |
| 🗣️ Hotkey Read Aloud:  [ CommandOrControl+Alt+R    (UI: Alt+I) ] |
| 🌐 Bahasa Inferensi:   [ auto  (auto | id | en)                 ▼ ] |
+-------------------------------------------------------------+
| 🤖 Model STT:          [ whisper-tiny-gguf (ggml-base-id-q8_0) ▼ ] |
| 🔊 Mesin TTS:          [ Suara sistem                           ▼ ] |
+-------------------------------------------------------------+
Kolom input pintasan menampilkan placeholder singkat seperti Alt+. atau Alt+I demi kejelasan visual, namun bawaan yang tersimpan mengikuti pola CommandOrControl+Alt+X yang ditunjukkan dalam tanda kurung. Simpan pintasan baru dari antarmuka pengaturan untuk menimpa bawaan tersebut.
Mode Speech-to-Text (STT) & Dikte
Snipset merutekan setiap sesi dikte melalui mesin Whisper lokal (Whisper (Offline)), dengan Web Speech API browser hanya dijadikan fallback untuk build pratinjau non-Tauri. Aplikasi desktop mendukung tiga mode voice input yang dapat dipetakan ke trigger pintasan pilihanmu:
1. Dikte Langsung (dictate)
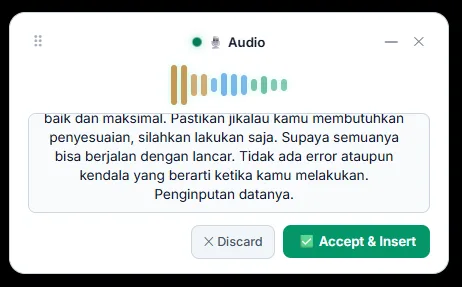
Gunakan mode Push-to-Talk (tahan tombol) atau Toggle (tekan sekali) pada pintasan dikte, ucapkan kalimat Anda secara alami, lalu lepas tombol. Snipset akan mentranskripsikan suara secara real-time dan mengetikkan hasilnya langsung di posisi kursor aktif.
- Akumulasi Teks Kontinu: Jeda hening saat Anda berpikir tidak akan menutup rekaman secara prematur. Transkripsi teks akan terus terakumulasi dengan aman melintasi beberapa segmen ucapan.
- Tanda Baca & Huruf Kapital: Mengubah kata tanda baca yang diucapkan ("koma", "titik", "baris baru") menjadi simbol di semua mode; mode Smart juga menambahkan tanda baca dan huruf kapital secara otomatis.
- Injeksi Kursor Native: Menggunakan sintesis input Windows tingkat rendah untuk mengetik langsung ke IDE, terminal/CMD, aplikasi chat, hingga formulir browser. Klik Accept & Insert untuk mengetik atau Discard untuk membatalkan.
2. Terjemahan Suara Langsung / Live Voice Translation (translate)
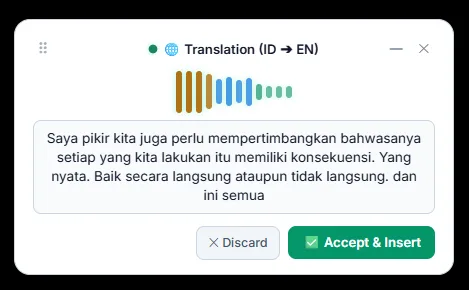
Bicaralah dalam bahasamu, dan Snipset akan secara otomatis mentranskripsikan serta mengetikkan teks terjemahan dalam bahasa target pilihanmu secara real-time.
Snipset saat ini hanya mendukung terjemahan dua arah antara Bahasa Inggris dan Bahasa Indonesia. Pasangan bahasa lain belum tersedia.
- Alur Kerja Bilingual EN ↔ ID: Ideal untuk menyusun email lintas negara, menerjemahkan poin rapat antar rekan, atau mencatat catatan suara dwibahasa.
- Pratinjau Terjemahan: Tinjau teks terjemahan akhir di hamparan mengambang sebelum menyetujui penyisipan.
3. Voice AI: Ask Anything (ask_anything)
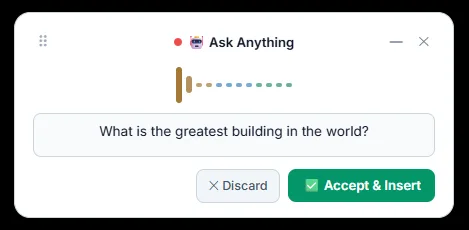
Ucapkan pertanyaan kompleks atau instruksi coding. Snipset akan menangkap suara, mengubahnya menjadi teks terstruktur, meneruskannya ke model Ollama lokal atau asisten Cloud AI aktif, lalu menampilkan respons pada kartu overlay.
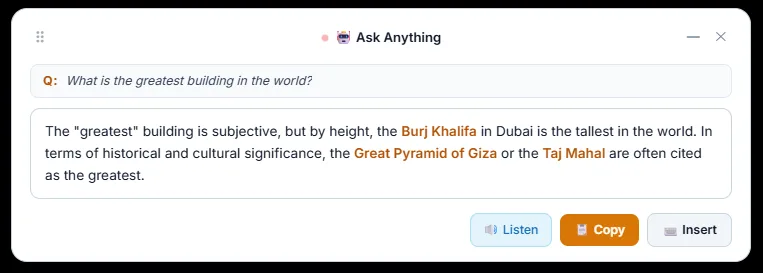
- Suara ke Prompt AI: Pertanyaan lisan Anda diubah menjadi prompt terstruktur secara instan.
- Tindakan Terintegrasi:
- Listen (TTS): Membacakan jawaban AI menggunakan mesin sintesis suara neural yang Anda pilih.
- Copy: Menyalin jawaban ke papan klip sistem.
- Insert: Mengetikkan jawaban yang dihasilkan AI langsung ke dokumen atau editor aktif Anda.
Memilih Penyedia Ucapan-ke-Teks
Semua mode dikte di atas berjalan pada penyedia yang kamu pilih di Settings → Audio & Voice → Penyedia Ucapan-ke-Teks. Ada dua opsi:
- Whisper Offline (bawaan, privat): Berjalan sepenuhnya di perangkatmu tanpa akses jaringan. Ini adalah bawaan pada instalasi baru, jadi apa pun yang kamu ucapkan tidak meninggalkan mesinmu kecuali kamu mengubahnya.
- Gemini Cloud (Google): Mesin cloud yang bersifat opt-in. Saat dipilih, audio dikte dikirim ke Google untuk transkripsi Smart dan poles Layer 2 lokal dilewati secara bawaan demi kecepatan.
Untuk mengaktifkan penyedia cloud:
- Buka Settings → Audio & Voice lalu atur Penyedia Ucapan-ke-Teks ke Gemini Cloud (Google).
- Tempel kunci API Gemini milikmu sendiri ke kolom kunci. Kunci disimpan di keyring sistem operasi (atau penyimpanan terenkripsi), bukan di database plaintext.
- Tekan Uji Koneksi. Snipset memvalidasi kunci terhadap metadata model Google sebelum audio apa pun dikirim, sehingga kunci yang salah atau tidak tersedia langsung ketahuan di awal. Pemeriksaan yang berhasil melaporkan bahwa akses model terverifikasi; setelah itu kamu bisa mencoba dikte untuk menguji transkripsi langsung.
Sampai kunci yang valid tersimpan, penyedia tetap di Whisper Offline meski Gemini Cloud dipilih, jadi dikte tetap berjalan. Kamu bisa kembali ke Whisper Offline kapan saja, dan dasbor ucapan, banner privasi, serta overlay perekaman selalu menampilkan mesin mana yang menghasilkan teks saat ini.
Memakai ElevenLabs untuk Teks-ke-Ucapan
Read Aloud bisa memakai suara yang ada di perangkat ini (Suara sistem) atau ElevenLabs dengan kunci API milikmu sendiri. Pilihannya ada di Settings → Audio & Voice → Mesin teks-ke-ucapan:
- Atur Mesin suara ke ElevenLabs.
- Tempel kuncimu ke kolom Kunci API ElevenLabs lalu tekan Simpan. Kunci disimpan di keychain sistem dan hanya dikirim ke
api.elevenlabs.io. ElevenLabs menagih pemakaian per karakter ke akunmu. Pakai Tampilkan kunci untuk memeriksa kunci yang kamu tempel, atau Hapus untuk menghapusnya. - Tekan Uji, lalu pilih Model (Flash v2.5: lebih cepat atau Multilingual v2: lebih baik untuk angka) dan Suara dari daftar yang dimuat dari akun ElevenLabs-mu. Tekan Muat ulang suara setelah kamu menambah suara di ElevenLabs.
Jika kamu membuat kunci terbatas di dasbor ElevenLabs, beri kunci itu izin Text to Speech dan Voices (read). Tanpa Voices (read), Uji melaporkan "Kunci ini butuh izin Text to Speech dan Voices (read)." dan baris Suara menampilkan "Kunci ini butuh izin Voices (read) untuk memuat daftar suara." Kamu tidak perlu membuat kunci baru: ubah kunci yang sudah ada di dasbor ElevenLabs untuk menambahkan izin yang kurang, lalu tekan Uji dan Muat ulang suara lagi.
Post-Hoc Keystroke Learning & Evaluasi Edit Rate
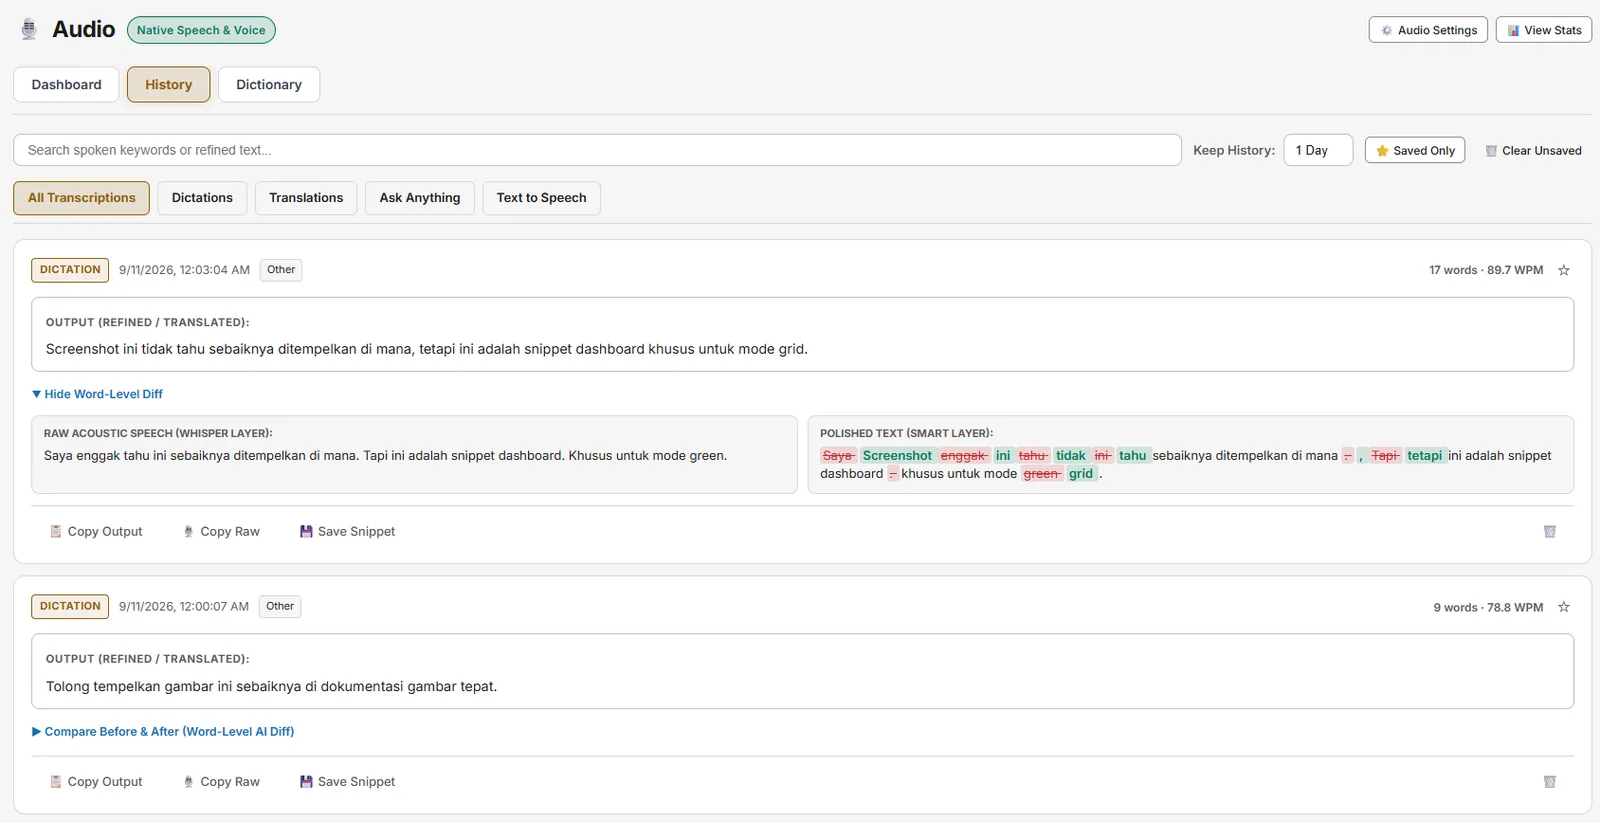
Snipset dilengkapi mekanisme pembelajaran adaptif di latar belakang berdasarkan koreksi manual yang Anda lakukan setelah mendikte atau menerjemahkan suara:
- Jendela Koreksi 12 Detik (dibatasi 3 hingga 60 detik): Setelah sesi dikte atau penerjemahan berakhir, Snipset memantau ketukan keyboard manual dan backspace pada aplikasi target (hingga batas waktu bawaan 12 detik, atau saat tombol Enter/Tab/Escape ditekan). Jendela ini dapat dikonfigurasi antara 3 hingga 60 detik.
- Evaluasi Edit Rate Real-Time: Menghitung jarak sunting (Levenshtein edit distance) antara teks yang diinjeksikan dengan hasil akhir yang Anda ketik. Pengetikan kelanjutan biasa (append) tidak dihitung sebagai kesalahan.
- Saran Kamus Tertunda: Saat Anda mengoreksi istilah yang salah dikenali atau diterjemahkan, Snipset merekam proposal ke antrean Kamus Suara dengan isolasi cakupan (dikte vs bahasa terjemahan target). Saran tidak akan aktif sebelum disetujui secara eksplisit oleh pengguna.
Floating Speech Overlay HUD
Saat merekam, jendela floating HUD yang ringkas akan muncul di layar:
- Live VU Meter & Waveform: Visualisasi level input mikrofon secara real-time.
- Indikator Status: Umpan balik visual untuk status Listening, Transcribing, Synthesizing, dan Editing.
- Kartu Respons AI dengan TTS: Pada mode Ask Anything, tinjau kartu respons AI dengan tombol Play, Pause, Resume, Stop, dan Copy.
- Audio Feedback Soundpacks: Isyarat audio opsional (soft chimes) saat rekaman dimulai, dihentikan, atau berhasil diproses.
Anda dapat menggeser jendela floating speech overlay HUD ke posisi mana saja di layar. Koordinat posisi tersebut akan tersimpan otomatis.
Text-to-Speech (TTS) & Read Aloud
Mesin Read Aloud memungkinkanmu mendengarkan dokumen panjang, diff pada pull request, email, atau cuplikan teks tanpa membuat mata lelah.
Menjalankan Read Aloud
- Salin Teks: Salin teks yang ingin kamu dengar di jendela mana pun (VS Code, Chrome, Outlook, Notion). Read Aloud membaca teks di papan klip, bukan teks yang sedang disorot, jadi sorotan yang belum disalin tidak akan dibaca. Kalau papan klip tidak berisi teks, Read Aloud mengucapkan pengingat singkat.
- Pintasan Global: Tekan
CommandOrControl+Alt+R(antarmuka pengaturan menampilkanAlt+Isebagai placeholder), atau hotkey kustommu. - Overlay Kontrol: Kendalikan pemutaran (Play, Pause, Resume, Stop) dari HUD atau tombol media keyboard.
Mesin Suara
Read Aloud berbicara dengan mesin yang dipilih di Pengaturan → Audio & Voice → Mesin teks-ke-ucapan. Suara sistem adalah bawaan dan diputar melalui Web Speech API WebView aktif (Edge, Chrome, atau WebView2). ElevenLabs mengirim teks ke api.elevenlabs.io dengan kunci API milikmu sendiri; langkah pengaturannya ada di Memakai ElevenLabs untuk Teks-ke-Ucapan di atas. Backend Rust mengekspos model id native-speech-synthesis yang hasilnya saat ini adalah fallback waveform untuk pengujian, bukan sintesis suara bagi pengguna akhir. Saat ini belum ada backend SAPI5, Sherpa-ONNX, Kokoro, atau Edge Neural cloud yang terpasang di Snipset.
Kalau ElevenLabs tidak bisa membacakan teks (misalnya izin kunci kurang, kuota habis, atau tidak ada koneksi), Read Aloud membacakannya dengan suara lokal di perangkat ini. Selama notifikasi desktop aktif, notifikasi menjelaskan alasannya, sekali per alasan sampai Snipset dimulai ulang. Cadangan ini butuh setidaknya satu suara yang terpasang di perangkat ini.
| Mode Mesin | Keterangan | Latensi | Kebutuhan Internet |
|---|---|---|---|
| Suara sistem | Mensintesis suara melalui suara-suara yang terpasang di WebView (Edge, Chrome, atau WebView2). | Rendah | Opsional (bergantung browser) |
| ElevenLabs | Mensintesis suara di server ElevenLabs dengan kunci API milikmu, ditagih per karakter. | Jaringan | Wajib |
Kustomisasi Suara & Pemutaran
- Kecepatan (WPM): Sesuaikan kecepatan teleprompter RSVP dan Read Aloud dalam kata per menit (WPM) dari 100 hingga 600 dengan bawaan 250 WPM.
- Pemilihan Suara: Dengan Suara sistem, pilih dari suara yang terpasang di WebView lewat dropdown Suara di Pengaturan → Audio & Voice. Suara yang tersedia bergantung pada WebView dan sistem operasimu.
- Profil Suara Kurasi: Pilih profil bernama (Otomatis, Google Indonesia, Perangkat Indonesia, Google Inggris, Perangkat Inggris) di Pengaturan → Audio & Voice. Setiap profil yang tampil sudah terhubung ke satu suara konkret di perangkatmu: profil yang suaranya tidak tersedia disembunyikan, dan tidak ada penggantian suara secara diam-diam.
- Realitas Platform:
Google Bahasa Indonesiadan suara Google lainnya memakai jaringan dan tersedia di Chrome, Edge, serta Android. WebView2 di Windows hanya menampilkan suara yang terpasang di sistem operasimu, jadi profil Google tidak muncul di sana. Profil perangkat memilih suara lokal yang terpasang supaya pemutaran tetap berjalan offline. Di Linux, WebKitGTK meminta daftar suara kespeech-dispatcher, jadi dropdown Profil Suara yang kosong berarti lapisan itu belum ada, bukan Snipset yang gagal. Pasangspeech-dispatcherdanespeak-ng(sudo pacman -S speech-dispatcher espeak-ngdi Arch, atausudo apt install speech-dispatcher espeak-ngdi Debian/Ubuntu), cek lapisannya denganspd-say "Hello", lalu mulai ulang Snipset. Ini sudah diverifikasi di Arch Linux dengan KDE Plasma: setelah dua paket itu terpasang, dropdown Profil Suara terisi dan Test Voice terdengar. Perlu dicatat, espeak-ng adalah sintesis format, jadi suaranya mudah dipahami tapi sengaja terdengar robotik. Ini cadangan offline yang andal, bukan suara yang terdengar natural. - Tanpa Cache TTS di Disk: Membaca ulang teks yang identik pada sesi yang sama memakai ulang utterance queue Web Speech API; saat ini belum ada cache audio sintesis persisten di disk.
Kamus Suara Personal (Custom Dictionary)
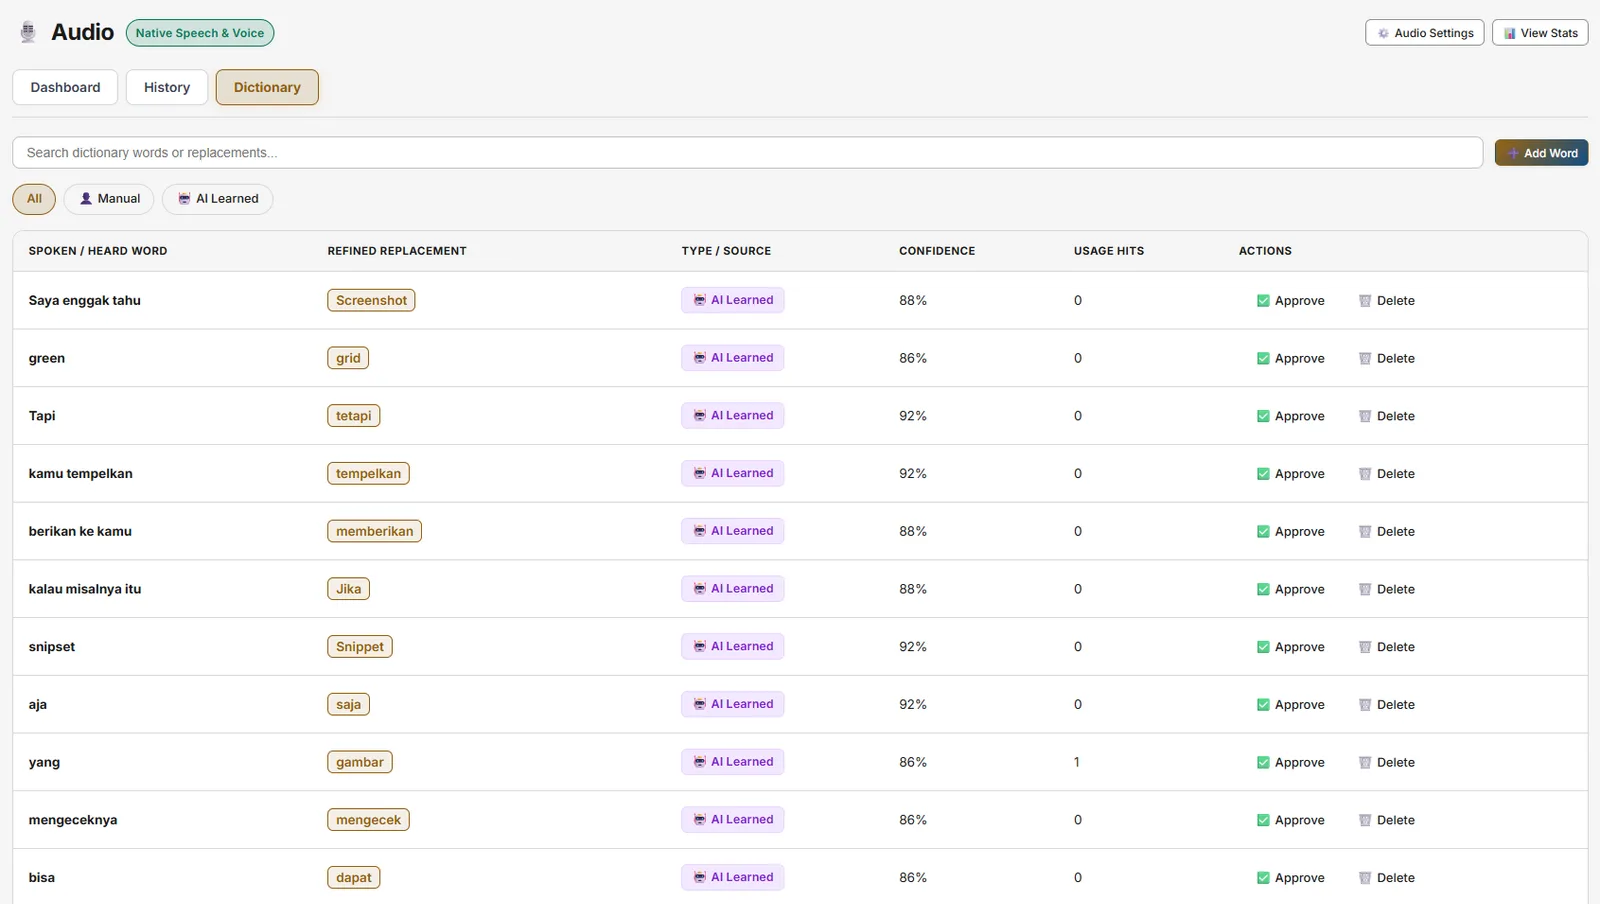
Istilah teknis khusus, nama library, atau kode (syntax) seperti Kubernetes, PostgreSQL, Axios, OAuth2 terkadang dapat salah dikenali oleh model akustik umum.
Snipset menyediakan fitur Kamus Suara Kustom:
- Buka Sistem → Pengaturan → Audio & Voice → Custom Dictionary.
- Tambahkan Trigger Word (cara pengucapan) dan Replacement Text (teks yang seharusnya diketik).
- Pembelajaran Otomatis: Tinjau saran kosakata yang dipelajari otomatis dari koreksi keystroke Anda dan setujui dengan satu klik.
Preprocessing Audio Hardware
Untuk menjaga akurasi transkripsi di berbagai kondisi ruangan, Snipset menyertakan filter audio DSP (Digital Signal Processing) bawaan:
- Automatic Gain Control (AGC): Menyesuaikan volume input secara dinamis sehingga suara bisikan maupun suara lantang terdengar seimbang.
- Noise Suppression: Menyaring suara dengung pendingin ruangan, ketikan keyboard, kipas komputer, dan kebisingan latar belakang.
- Acoustic Echo Cancellation (AEC): Mencegah suara dari speaker komputer masuk kembali ke mikrofon dan memicu putaran gema.
- Preset Jarak Mikrofon:
- Laptop / Webcam Mic: Profil high-gain yang dioptimalkan untuk jarak 1–2 meter.
- USB / Headset Mic: Profil low-gain jarak dekat untuk suara yang jernih dan fokus.
Performa & Kebutuhan Perangkat Keras
Speech-to-text dirancang berjalan sepenuhnya di CPU-mu, dan kamu tidak butuh GPU khusus. Memahami biaya tiap lapisan membantumu menaruh ekspektasi yang tepat di mesin lama:
- Whisper lokal (model bawaan): Model offline
ggml-base-id-q8_0berjalan di CPU dan butuh sekitar 300 MB memori untuk beroperasi. Prosesor x86-64 modern mentranskripsikan ucapan pendek dalam beberapa detik; di laptop dual-core yang lebih tua, siapkan ekspektasi di batas atas. Snipset memetakan thread CPU secara otomatis, jadi tidak ada yang perlu kamu atur. - Penyempurnaan Layer 2 (opsional, butuh Ollama): Diktasi "Smart", terjemahan, dan Ask Anything memakai model Ollama lokal sebagai lapisan kedua untuk perapian teks, format, dan jawaban. Kalau Ollama tidak terpasang, diktasi tetap selesai dan mengembalikan transkrip Layer 1-mu, terjemahan mengembalikan teks tanpa terjemahan, dan Ask Anything menampilkan pesan bahwa AI lokal sedang offline. Pasang Ollama hanya jika kamu ingin fitur tambahan ini; model 8B butuh sekitar 8 GB RAM tersisa (lihat tutorial Ollama untuk detailnya).
- Kalau pemrosesan terasa lambat: Pastikan tidak ada proses lain yang memakai port 11434, dan periksa apakah proxy sistem atau perangkat lunak keamanan mencegat koneksi ke
localhost, karena keduanya bisa mengubah "Ollama tidak ada" menjadi penantian panjang. Di Windows, audio direkam lewat WebView (beda dengan jalur perekaman native di Linux), jadi pastikan driver audio-mu selalu mutakhir. - Diagnosis lewat log: Telemetri waktu pemrosesan ditulis ke berkas log. Di Windows:
%LOCALAPPDATA%\Snipset\logs\snipset.log(menu Pengaturan juga punya aksi membuka folder log). Lampirkan barisSPEECHsaat kamu melaporkan kelambatan agar penyebabnya mudah terlihat.
Memecahkan Masalah Pemrosesan Lambat
Kalau pemrosesan dikte rutin memakan waktu lebih dari beberapa detik:
- Periksa apakah Ollama terpasang dan benar-benar berjalan (
ollama --versiondi terminal). Tanpanya, penyempurnaan Layer 2 tidak bisa menjawab; dengannya, model dimuat saat pemakaian pertama, jadi permintaan paling awal adalah yang paling lambat. - Buka berkas log sambil mengulang kondisi lambatnya. Di Windows:
%LOCALAPPDATA%\Snipset\logs\snipset.log; di Linux:~/.local/share/Snipset/logs/snipset.log. BarisSPEECHmembawa JSON timing (refine_ms,discovery_ms,vision_probe_ms,wait_ms) yang langsung menyebut tahap mana yang lambat. - Periksa apakah proxy sistem atau perangkat lunak keamanan mencegat koneksi ke
localhost, dan apakah proses lain memakai port 11434. Keduanya mengubah "Ollama tidak ada" menjadi penantian panjang. - Lampirkan baris
SPEECHsaat kamu melaporkan masalahnya. Isinya hanya data timing, tidak pernah audio atau isi transkrip.
Privasi, Keamanan & Retensi Data
Snipset menyimpan data wicara pada perangkatmu secara bawaan. STT berjalan lokal lewat Whisper (whisper-rs + ggml-base-id-q8_0.bin) dan tidak pernah mencapai server eksternal selama kamu memakai provider bawaan. TTS dengan Suara sistem memakai sintesis suara WebView: profil suara Google yang memakai jaringan menghubungi vendor browser untuk mengalirkan data suara, sementara profil perangkat sepenuhnya offline. TTS dengan ElevenLabs mengirim teks yang dibacakan ke api.elevenlabs.io memakai kunci API milikmu, yang tetap tersimpan di keychain sistem.
- Tanpa Rekaman Cloud untuk STT: Saat memakai model Whisper lokal bawaan, audio tidak pernah keluar dari komputer.
- Gemini Cloud itu opt-in: Kalau kamu memilih provider Gemini dan menyimpan kredensial, audio dikirim ke Google untuk transkripsi Smart dan Layer 2 lokal dilewati secara default. Kredensial tersimpan di keyring OS atau penyimpanan terenkripsi, bukan di database plaintext. Kamu bisa kembali ke Whisper Offline kapan saja.
- Kebijakan Retensi: Atur aturan pembersihan file audio otomatis: 1 Hari, 1 Minggu, 1 Bulan, 1 Tahun, atau Selamanya. Bawaannya adalah 1 Hari.
- Penyimpanan Lokal Saja: Catatan riwayat suara dan file WAV sementara berada di direktori data aplikasi pribadimu. Data tersebut tidak dienkripsi saat disimpan; hanya entri papan klip dan rahasia one-time-password yang dilindungi dengan DPAPI saat ini.
- Pembersihan Sekali Klik: Hapus seluruh rekaman audio yang tersimpan secara instan melalui Pengaturan → Audio & Voice → Purge All Recordings (dan purge per entri pada Riwayat Speech).
Referensi Konfigurasi & Pengaturan
| Kunci Konfigurasi | Tipe | Standar | Keterangan |
|---|---|---|---|
shortcut_dictate | String | CommandOrControl+Alt+D | Pintasan global untuk memulai/menghentikan dikte Speech-to-Text. |
shortcut_translate | String | CommandOrControl+Alt+T | Pintasan global untuk memulai/menghentikan Live Voice Translation. |
shortcut_ask_anything | String | CommandOrControl+Alt+A | Pintasan global untuk memulai/menghentikan Voice AI Ask Anything. |
shortcut_read_aloud | String | CommandOrControl+Alt+R | Pintasan global untuk memicu Text-to-Speech Read Aloud. |
active_model_id | String | whisper-tiny-gguf | Model pengenalan suara akustik yang aktif. Runtime bawaan memakai berkas model ggml-base-id-q8_0.bin. |
stt_provider | String | local | Provider STT: local (Whisper offline, bawaan) atau gemini (cloud opt-in, kirim audio ke Google). |
enhance_with_layer2 | Boolean | false | Kalau true, jalur Gemini cloud dipoles lagi dengan Layer 2 lokal (tone dan konteks visual). |
visual_context_enabled | Boolean | false | Kalau true, Layer 2 menerima tangkapan layar jendela aktif. Gambar dikirim ke endpoint Ollama yang kamu atur, yang bisa berupa model cloud. |
inference_language | String | auto | Petunjuk bahasa lisan saat mendikte. Nilai yang didukung saat ini: auto, id, en. |
translation_target_lang | String | id | Bahasa tujuan saat memakai Live Voice Translation. Nilai yang didukung saat ini: en, id. |
personalization_enabled | Boolean | true | Mengaktifkan proposal koreksi pasca-sisip dan kosakata adaptif. |
auto_gain_control | Boolean | true | Normalisasi penguatan volume tingkat browser. |
noise_suppression | Boolean | true | Filter peredam kebisingan tingkat browser. |
echo_cancellation | Boolean | true | Pembatalan gema akustik tingkat browser. |
mic_gain_boost | Number | 1.0 | Pengali penguatan mikrofon perangkat lunak (1.0x hingga 3.0x, dibatasi 1.5x ketika AGC aktif). |
tts_rsvp_wpm | Number | 250 | Kecepatan pemutaran Read Aloud dan RSVP dalam kata per menit (100 hingga 600). |
soundpack | String | modern_chime | Soundpack umpan balik audio (modern_chime, minimal_click, soft_pop, silent). |
observation_window_secs | Number | 12 | Jendela observasi edit pasca-sisip dalam detik (dibatasi 3 hingga 60). |
retention_period | String | 24_hours | Batas waktu penyimpanan berkas WAV sebelum pembersihan otomatis (24_hours, 1_week, 1_month, 1_year, never). |