AI Integration
Pencarian Semantik & Embeddings
Pahami bagaimana penyematan vektor mendukung OmniSearch Snipset.
Halaman ini mencakup dasar-dasar teknis OmniSearch: penyematan vektor. Jika Anda belum menyiapkan OmniSearch, mulailah dengan Halaman fitur OmniSearch . Panduan ini membahas lebih dalam tentang cara kerja sistem penyematan dan cara mengelola database Anda.
Apa itu Penyematan Vektor?
Komputer tidak memahami “makna” kata-kata secara organik. Untuk mengatasi hal ini, AI menggunakan penyematan vektor.
- Penyematan adalah representasi matematis dari makna teks sebagai daftar angka ("vektor").
- Dua teks dengan makna serupa akan memiliki vektor matematika serupa, meskipun menggunakan kata-kata yang sama sekali berbeda.
- Misalnya: "Saya harus membatalkan langganan" dan "Bagaimana cara berhenti berlangganan?" akan memiliki penyematan yang sangat mirip, memungkinkan mesin pencari untuk menghubungkannya.
- Snipset menggunakan model embedding lokal (misalnya
hf.co/lmstudio-community/embeddinggemma-300m-qat-GGUF) yang berjalan melalui Ollama untuk menghasilkan vektor-vektor ini.
Basis Data Penyematan
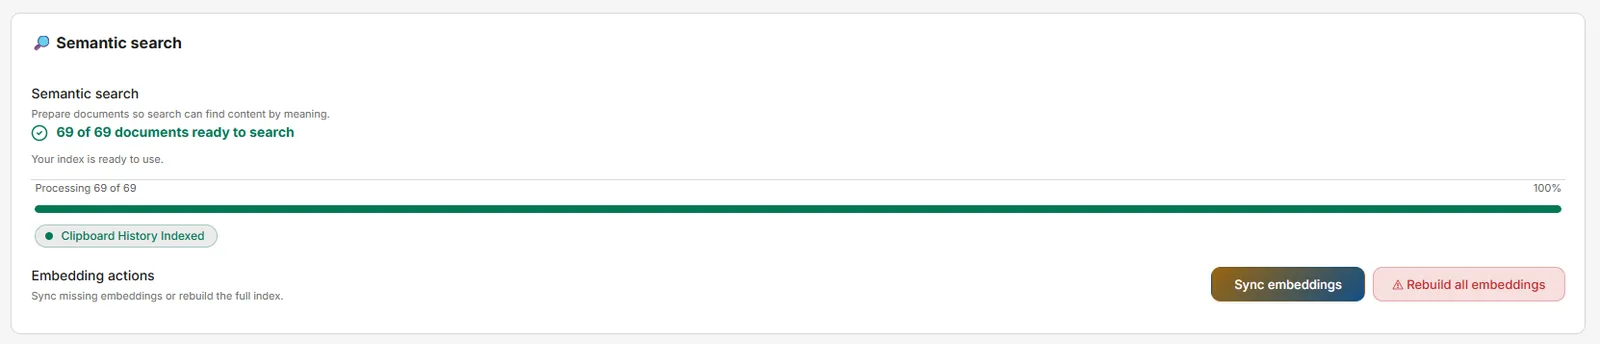 Karena penghitungan penyematan memerlukan pemrosesan AI, Snipset tidak melakukannya dengan cepat saat Anda melakukan penelusuran. Sebaliknya, ia menghitung terlebih dahulu dan menyimpannya.
- Penyematan disimpan dalam tabel vektor khusus di dalam database SQLite lokal Anda (
snipset.db). - Setiap cuplikan mendapat tepat satu entri penyematan. Entri ini merupakan kombinasi Nama cuplikan, Kata Kunci, dan Konten.
- Jejak basis datanya sangat kecil; bertambah sekitar 1,5 KB per cuplikan.
Kontrol Sinkronisasi
Di panel pengaturan OmniSearch, Anda memiliki kontrol yang tepat atas proses pembuatan penyematan:
| Tindakan | Apa fungsinya |
|---|---|
| Mulai Pematrian | Mulai menyematkan semua cuplikan yang belum memiliki entri vektor. Benar-benar aman untuk menjalankan ini kapan saja. |
| Jeda | Menghentikan sinkronisasi untuk sementara. Kemajuan saat ini disimpan, memungkinkan Anda melanjutkan kapan pun Anda mau. |
| Lanjutkan | Melanjutkan proses dari tempat yang dijeda. Ini hanya memproses sisa cuplikan yang tidak tersemat. |
| Paksa Semua | Menghapus SEMUA embeddings yang ada di database dan membuatnya kembali dari awal. |
Menjaga Penyematan Tetap Terkini
- Jika Anda melakukan impor CSV/JSON secara besar-besaran sebanyak ratusan cuplikan.
- Jika Anda mengubah Model Penyematan di pengaturan Konfigurasi AI.
- Jika hasil penelusuran semantik tampak tidak akurat atau ketinggalan zaman.
Menonaktifkan Embedding Otomatis dan Pencarian Semantik
Bagian Pencarian semantik juga menyediakan dua sakelar independen:
- Embedding otomatis: saat nonaktif, snippet baru, item clipboard, dan teks OCR tidak lagi diindeks di latar belakang. Sinkronisasi dan Bangun ulang manual tetap berfungsi selama pencarian semantik aktif.
- Pencarian semantik dan saran: saat nonaktif, OmniSearch kembali ke pencocokan kata kunci dan saran clipboard dijeda. Sinkronisasi dan Bangun ulang dinonaktifkan sampai Anda mengaktifkannya lagi.
Kedua sakelar aktif secara bawaan. Menonaktifkan salah satunya tidak pernah menghapus vektor yang tersimpan, sehingga pengaktifan kembali langsung berlanjut tanpa mengindeks ulang dari awal.
Pertimbangan Kinerja
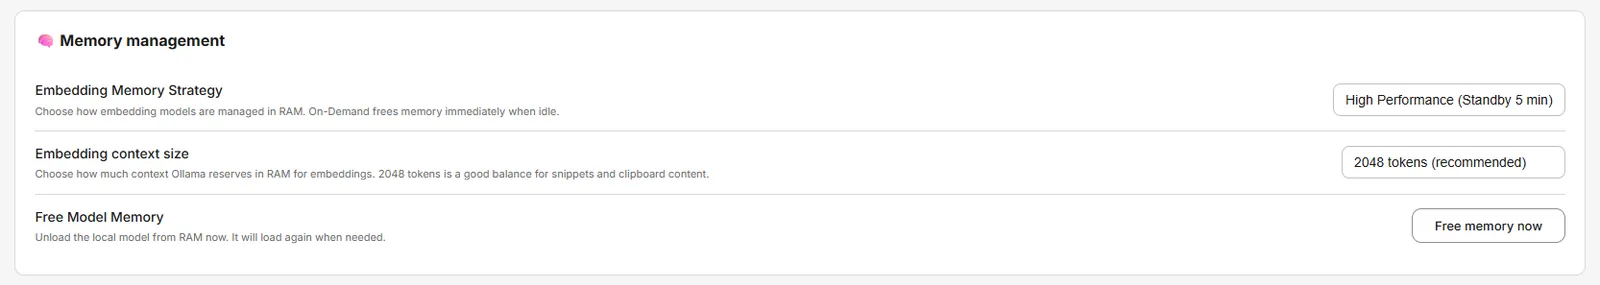 Menghasilkan embeddings memerlukan CPU atau GPU Anda untuk memproses data melalui Ollama.
- Untuk perpustakaan besar (misalnya, 500+ cuplikan), Sinkronisasi Paksa mungkin memerlukan waktu beberapa menit.
- Sistem Jeda/Lanjutkan memastikan Anda tidak pernah terkunci. Anda dapat menghentikan sinkronisasi kapan saja jika komputer Anda menjadi lamban.
- Tidak ada dampak pengetikan: Mesin perluasan teks inti Snipset berjalan pada thread terpisah dengan prioritas tinggi. Meskipun sinkronisasi besar-besaran berjalan di latar belakang, cuplikan Anda akan terus terpicu secara instan tanpa jeda.